
NVIDIA TESLA P100 16 GB
HPC i Deep Learning.
Akcelerator GPU oparty na architekturze Pascal z pamięcią HBM2.
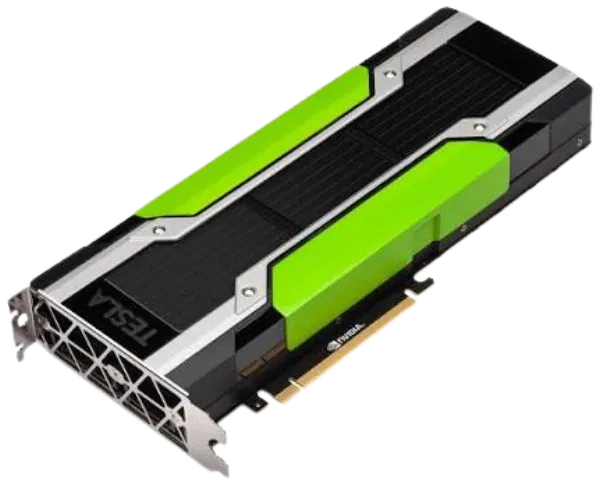
3 584 rdzeni CUDA16 GB HBM2732 GB/s18,7 TFLOPS FP16
Deep Learning
Szkolenie sieci
neuronowych
HBM2 16 GB
Ultraszybka pamięć
o dużej przepustowości
Obliczenia FP64
4,7 TFLOPS
do HPC i symulacji
Pełna specyfikacja
- Architektura
- NVIDIA Pascal (GP100)
- Pamięć
- 16 GB HBM2
- Przepustowość pamięci
- 732 GB/s
- Rdzenie CUDA
- 3584
- Wydajność FP64
- 4,7 TFLOPS
- Wydajność FP32
- 9,3 TFLOPS
- Wydajność FP16
- 18,7 TFLOPS
- Interfejs
- PCIe 3.0 ×16
- TDP
- 250 W
- Chłodzenie
- Pasywne (serwerowe)
- Format
- Dwuslotowy, pełna wysokość
- Zasilanie
- 8-pin EPS
- W komplecie
- Kabel zasilający 2× PCIe 8-pin → EPS 8-pin
- Stan
- Używany
- Gwarancja
- 3 miesiące
- Kwalifikacja
- 6-etapowa kwalifikacja techniczna (m.in. gpu-burn 600 s) — wynik PASS, certyfikat kwalifikacji
Baza wiedzyPoradniki i testy dotyczące tego modelu6 artykułów
GPU do laboratorium i na uczelnię bez budżetu na H100 - jak zbudować stanowisko AI/HPC taniej
2× GPU do LLM: jak llama.cpp dzieli model między P40 i V100
PLLuM lokalnie na używanej Tesli - jak odpalić i ile VRAM
Benchmarki: Bielik i PLLuM na P40/P100/V100 - realne tokeny/s z czasem prefill
RAG na firmowych dokumentach offline - jaki sprzęt i jak zacząć (RODO)
Ile prądu pobiera używana Tesla - i która daje najwięcej tokenów na wat