
Aktualna oferta
NVIDIA TESLA V100 32 GB
Moc AI. Bez kompromisów.
Akcelerator GPU do treningu deep learning i inferencji.
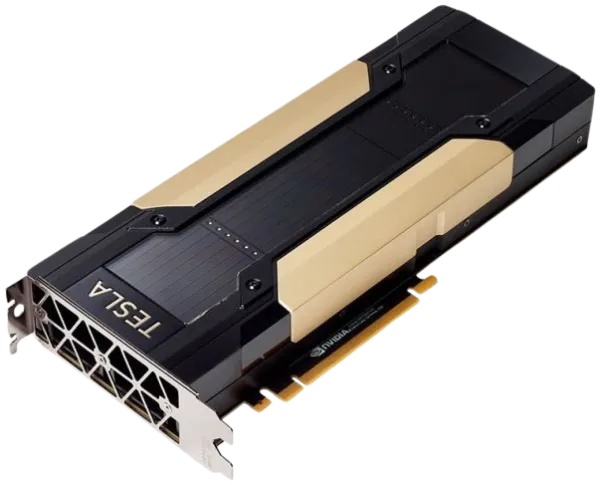
5 120 rdzeni CUDA640 rdzeni Tensor32 GB HBM2900 GB/s112 TFLOPS
Deep Learning
Trening modeli AI
FP16 na rdzeniach Tensor
HBM2 32 GB
Ultraszybka pamięć
900 GB/s przepustowości
Rdzenie Tensor
112 TFLOPS mocy
obliczeniowej
NVIDIA A2 16 GB
Cała moc AI. Bez daty ważności.
Ampere z rdzeniami Tensor i wsparciem najnowszego CUDA.
40–60 W, zasilanie przez PCIe.
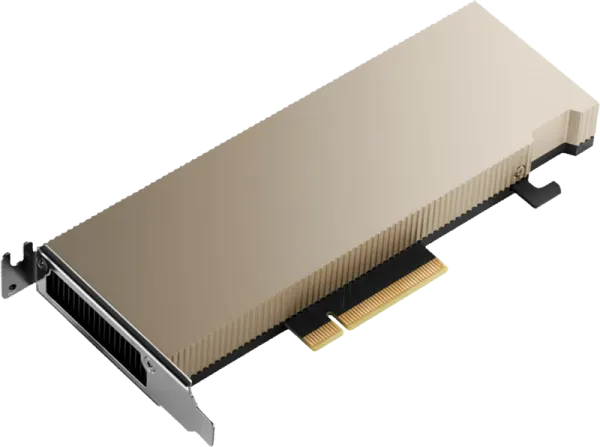
1 280 rdzeni CUDA40 rdzeni Tensor16 GB GDDR6200 GB/s36 TOPS INT8
Rdzenie Tensor
3. generacja
INT8 / FP16 / BF16
Wsparcie CUDA
Aktualne wersje CUDA Toolkit
i frameworków AI
40–60 W
Chłodzenie pasywne, zasilanie przez PCIe
Format odpowiedni do serwerów 1U
NVIDIA TESLA V100 16 GB
Pełna moc. Mniejszy budżet.
Akcelerator GPU do treningu deep learning i inferencji.
5 120 rdzeni CUDA640 rdzeni Tensor16 GB HBM2900 GB/s112 TFLOPS
Deep Learning
Trening modeli AI
FP16 na rdzeniach Tensor
HBM2 16 GB
Ultraszybka pamięć
900 GB/s przepustowości
Rdzenie Tensor
112 TFLOPS mocy
obliczeniowej
NVIDIA TESLA P40 24 GB
Inferencja AI. Maksymalna wydajność.
Akcelerator GPU zoptymalizowany do inferencji i wirtualizacji.
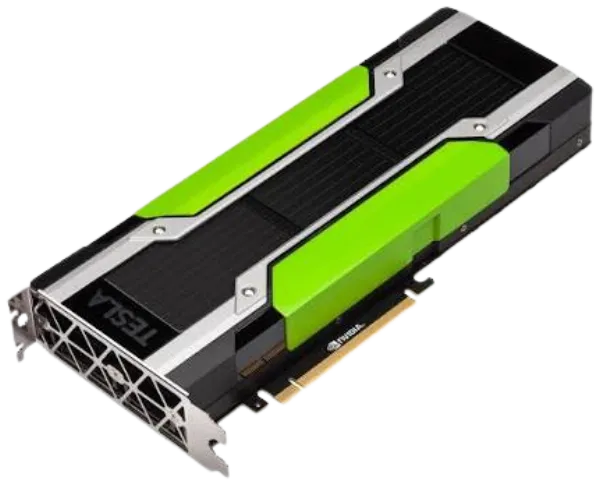
3 840 rdzeni CUDA24 GB GDDR5346 GB/s47 TFLOPS INT8
Inferencja
Zoptymalizowana do
inferencji INT8
GDDR5 24 GB
Duża pamięć dla
złożonych modeli
Wirtualizacja
Wsparcie NVIDIA GRID
i vGPU
NVIDIA TESLA P100 16 GB
HPC i Deep Learning.
Akcelerator GPU oparty na architekturze Pascal z pamięcią HBM2.
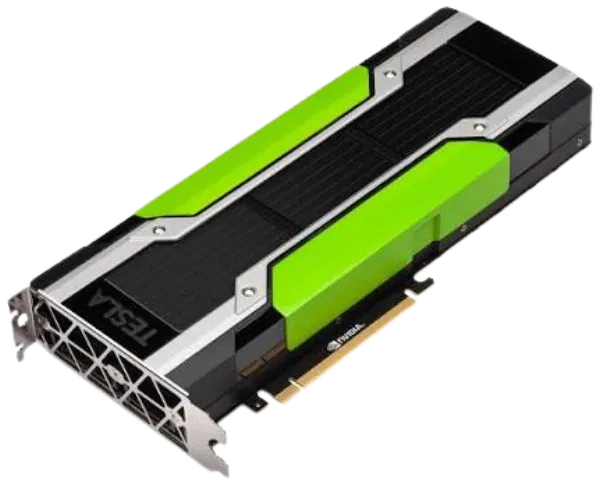
3 584 rdzeni CUDA16 GB HBM2732 GB/s18,7 TFLOPS FP16
Deep Learning
Szkolenie sieci
neuronowych
HBM2 16 GB
Ultraszybka pamięć
o dużej przepustowości
Obliczenia FP64
4,7 TFLOPS
do HPC i symulacji
NVIDIA TESLA P4 8 GB
Inferencja AI. Niski pobór mocy.
Kompaktowy akcelerator GPU do inferencji w centrach danych o niskim TDP.
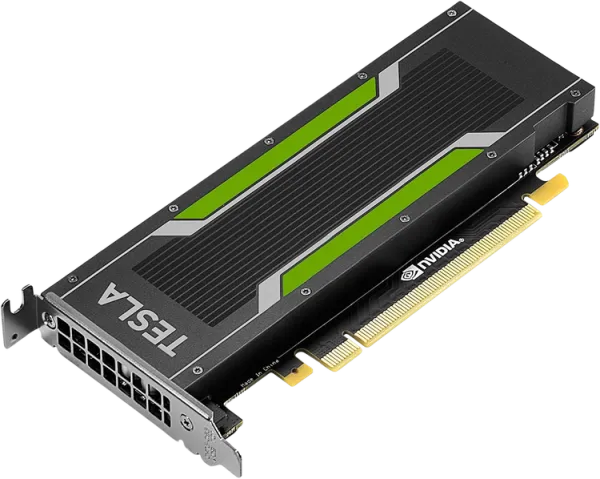
2 560 rdzeni CUDA8 GB GDDR5192 GB/s22 TOPS INT8
Inferencja
Zoptymalizowana do
wnioskowania INT8
GDDR5 8 GB
8 GB pamięci
GDDR5
75 W TDP
Pasywne chłodzenie,
bez dodatkowego zasilania