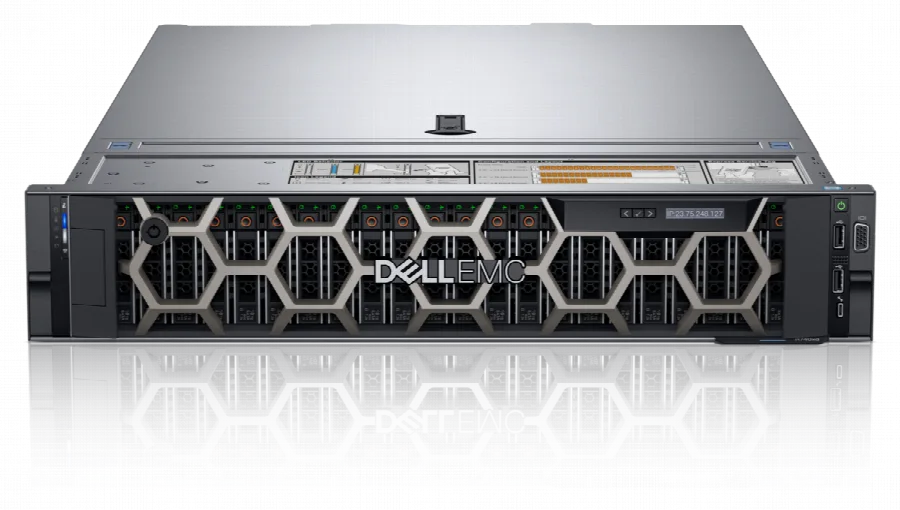
Serwery AI Dell PowerEdge R740 z NVIDIA Tesla V100 32 GB
Gotowe, przetestowane serwery GPU 2U oparte na Dell PowerEdge R740 z 1–3 akceleratorami NVIDIA Tesla V100 32 GB. Konfiguracje zapewniają od 32 do 96 GB HBM2 fizycznej pamięci GPU i są przygotowane do lokalnej inferencji LLM, fine-tuningu oraz klasycznych obciążeń deep learning. Serwer dostarczamy z kompletnym GPU enablement, skonfigurowanym chłodzeniem, zasilaniem i gwarancją 12 miesięcy.
Gotowy do uruchamiania obciążeń AI.
do 3× Tesla V100 32 GBdo 96 GB HBM2do 336 TFLOPS Tensordo 256 GB DDR4 ECC
Jedna platforma w trzech konfiguracjach sprzętowych. Każda wersja ma tę samą, w pełni wyposażoną bazę R740. Różnią się procesorami, liczbą kart V100 32 GB i ilością RAM — konfigurację można później rozbudować o kolejne karty GPU, bo zasilanie i okablowanie GPU są w zestawie od początku.
Konfiguracja podstawowa
Dell R740 AI Start — 1× Tesla V100 32 GB
32 GB HBM2 · 112 TFLOPS Tensor
Inferencja modeli do ~14B, prototypy, fine-tuning LoRA, jedna usługa AI w firmie.
Konfiguracja z 96 GB fizycznej pamięci GPU w trzech kartach, przeznaczona m.in. do większych modeli, dłuższego kontekstu oraz równoległego uruchamiania kilku usług.
Konfiguracje niestandardowe wyceniamy indywidualnie. Trzy przedstawione warianty stanowią standardowe konfiguracje bazowe. Jeśli Twój projekt wymaga innego zestawu, przygotujemy wycenę serwera R740 dobranego do Twojego obciążenia.
01
Karty GPU
Inna liczba kart V100 32 GB lub inne akceleratory z naszej oferty, np. Tesla P40 24 GB, Tesla P100 16 GB, Tesla V100 16 GB.
02
Pamięć RAM
Więcej lub mniej pamięci DDR4 ECC niż w wersjach standardowych.
03
Dyski
Inna liczba i pojemność dysków SSD oraz układ RAID.
04
Procesory
Inne modele Intel Xeon Scalable na zamówienie.
Prześlij informacje o planowanym obciążeniu, modelu lub środowisku. Na tej podstawie zaproponujemy konfigurację i przedstawimy wycenę, zwykle w ciągu jednego dnia roboczego.
Specyfikacja Dell PowerEdge R740 przygotowanego do obsługi GPU
Wspólna baza każdej konfiguracji. Platforma przygotowana do obsługi maksymalnie 3× GPU typu double-width, z kompletem riserów, chłodzenia, zasilania i kabli GPU. Procesory, RAM i GPU zależą od wersji.
Baza serwera
Model
Dell PowerEdge R740, 2U
Kontroler RAID
Dell PERC H730P Adapter
Kieszenie na dyski
16× 2,5" SFF
Sieć
2× 10GbE SFP+ + 2× 1GbE RJ45
Zarządzanie
iDRAC9 Enterprise
Zasilacze
2× 1600 W hot-plug
GPU enablement — kompletne wyposażenie dla 3× GPU typu double-width
Risery
Dell Riser Config 4:
Riser 1A (MDDTD)
Riser 2A (J7W3K)
Riser 3A (DTTHJ)
Chłodzenie
6× Dell 4VXP3 High Performance Fan
2× Dell C6R9H Low Profile / High Performance CPU Heatsink
Dell RFFDP GPU Air Shroud
Zasilanie GPU
3× Dell 4VPD3 GPU power cable
Komunikacja GPU↔GPU
PCIe 3.0 (wersja PCIe V100 nie ma mostka NVLink)
W zestawie i warunki
W zestawie
Dell ReadyRails, front bezel
Stan
Używany, po kwalifikacji technicznej każdej karty GPU i certyfikacji kompletnego serwera
Dostępna pamięć GPU jest jednym z głównych parametrów określających możliwy rozmiar modelu. Poniżej orientacyjne dopasowanie — dokładne wymagania zależą m.in. od długości kontekstu, wielkości batcha oraz używanego frameworka.
Dopasowanie zadań do liczby kart V100 32 GB
Zadanie
1× V100 32 GB
2× V100 64 GB
3× V100 96 GB
Inferencja LLM 7–14BFP16, np. Mistral 7B; Qwen 14B w FP16 przy krótszym kontekście lub w 8-bit
✓tak
✓tak
✓tak
Inferencja LLM ~30B8-bit ~32 GB lub 4-bit ~20 GB; FP16 ~60 GB samych wag
Kilka niezależnych usług narazniezależne obciążenia przypisane do poszczególnych kart
-nie
2
3
Ograniczenia architektury NVIDIA Volta: NVIDIA Tesla V100 oferuje rdzenie Tensor dla obliczeń mixed-precision FP16 oraz wysoką wydajność CUDA w FP32. Nie obsługuje BF16 ani FlashAttention 2. W PyTorch, vLLM czy llama.cpp modele mogą być uruchamiane w FP16 lub kwantyzacji — działa to stabilnie, a każda karta oferuje 32 GB pamięci HBM2.
GOTOWY DO PRACY
Serwer przygotowany do uruchomienia obciążeń.
01
Złożony i skonfigurowany
Karty zamontowane na riserach GPU, podłączone kablami zasilania GPU, pod osłoną powietrza GPU i z wentylatorami wysokiej wydajności.
02
Ubuntu ze skryptami testowymi
Preinstalowane Ubuntu z właściwymi sterownikami i skryptami testującymi, do weryfikacji sprzętu po odbiorze.
03
Wsparcie wdrożenia
Zapewniamy wsparcie w doborze konfiguracji oraz uruchomieniu pierwszego obciążenia.
CERTYFIKACJA
Certyfikacja serwera przed wysyłką — pełny przebieg testowy i dokumentacja egzemplarza
Każdy serwer przed wysyłką przechodzi pełny przebieg certyfikacyjny w dokładnie tej konfiguracji, w której zostanie dostarczony — z tymi procesorami, modułami pamięci, dyskami, kartami GPU, zasilaczami i interfejsami sieciowymi. Przed rozpoczęciem testów obciążeniowych system automatycznie porównuje wykrytą konfigurację z profilem oczekiwanym dla danego egzemplarza. Przebieg obejmuje stan wejściowy, obciążenia, stan wyjściowy oraz automatyczną ocenę kompletności materiału dowodowego. Przebieg przerwany, niepełny lub niespełniający kryteriów certyfikacyjnych nie może uzyskać statusu CERTIFICATION.
01
Stan wejściowy
Przed rozpoczęciem testów obciążeniowych sprawdzamy stan systemu raportowany przez iDRAC, zgodność wykrytej konfiguracji z profilem oczekiwanym, wersje firmware, profil BIOS, zasilacze i redundancję zasilania, interfejsy sieciowe, kontroler RAID oraz pełny, świeży inwentarz sprzętu z numerami seryjnymi. Dla każdej karty GPU odczytywana jest również rzeczywista szerokość i prędkość łącza PCIe z LnkSta. Przebieg nie przechodzi do właściwej certyfikacji, jeśli wymagane dane wejściowe są niekompletne lub konfiguracja nie odpowiada profilowi egzemplarza.
02
Obciążenia
Serwer przechodzi burn-in procesorów, test stabilności pamięci, diagnostykę SMART i self-test każdego nośnika w trybie obsługiwanym przez dany nośnik, kontroler i firmware, pomiar przepustowości pamięci, pomiar wydajności obliczeniowej procesorów, testy obliczeniowe GPU oraz testy OpenCL/CUDA. Na końcu wykonywane jest obciążenie łączne procesorów i wszystkich kart GPU. Temperatura, błędy ECC oraz zdarzenia systemowe są monitorowane w trakcie przebiegu.
03
Stan wyjściowy
Po obciążeniach ponownie sprawdzane są liczniki ECC kart GPU, dzienniki jądra, zdarzenia sprzętowe i stan kluczowych komponentów, a wyniki porównywane są ze stanem wejściowym. Ocena końcowa ma trzy niezależne warstwy: wynik sprzętu (Hardware Result), kompletność materiału dowodowego (Evidence Pipeline) i wynik certyfikacji (Certification Result), czyli końcową kwalifikację przebiegu jako certyfikację, walidację lub wynik negatywny. Certyfikat jest wydawany wyłącznie dla przebiegu zakończonego wynikiem CERTIFICATION.
Dokumentacja przekazywana z serwerem
Certyfikat (PDF) — tożsamość maszyny, konfiguracja z numerami seryjnymi, lista wykonanych etapów z wynikiem i czasem wykonania, końcowa kwalifikacja przebiegu wynikająca z automatycznych reguł certyfikacyjnych, kod weryfikacyjny.
Inwentarz sprzętu (JSON) — stan maszyny przed testem, z numerami seryjnymi procesorów, modułów pamięci per slot, dysków per bay, kart GPU i kontrolerów.
Self-test odbiorczy — samodzielne narzędzie uruchamiane po dostawie serwera, bez sieci i bez dostępu do kontrolera zarządzania. Potwierdza po dostawie, że wszystkie podzespoły są obecne i działają.
Opis pełnego przebiegu certyfikacyjnego i dokumentów wynikowych znajdziesz na osobnej stronie.
Budowa serwera AI to nie tylko wybór liczby kart GPU. Przygotowaliśmy techniczne materiały dotyczące platform rackowych, pamięci VRAM, rzeczywistej wydajności używanych Tesli oraz konfiguracji lokalnych modeli AI.
Dobór konfiguracji zależy przede wszystkim od wielkości modelu, sposobu kwantyzacji, długości kontekstu i liczby równoległych użytkowników. R740 z jedną V100 32 GB jest odpowiedni m.in. do modeli 7–14B. Dwie lub trzy karty pozwalają dzielić większe modele pomiędzy GPU oraz zwiększać dostępny budżet pamięci.
Ile kart NVIDIA Tesla V100 można zainstalować w oferowanym Dell R740?
Oferowana przez nas konfiguracja Dell PowerEdge R740 jest przygotowana pod maksymalnie trzy karty double-width NVIDIA Tesla V100 PCIe. Platforma zawiera odpowiednie risery, chłodzenie, zasilanie i okablowanie GPU.
Czy 3× V100 32 GB daje 96 GB wspólnego VRAM?
Nie automatycznie. Każda V100 ma własne 32 GB HBM2. Trzy karty dają łącznie 96 GB fizycznej pamięci GPU, ale model musi zostać podzielony pomiędzy karty przez framework lub backend obsługujący pracę multi-GPU.
Czy Dell R740 AI Start można później rozbudować do AI Pro lub AI Max?
Tak. Platforma jest od początku wyposażona w risery, chłodzenie, zasilanie i okablowanie wymagane do obsługi maksymalnie trzech kart double-width GPU. Rozbudowa polega przede wszystkim na dołożeniu kolejnych kart GPU oraz, jeśli wymaga tego docelowa konfiguracja, rozbudowie lub wymianie pamięci RAM i procesorów.
Czy Tesla V100 32 GB nadaje się do lokalnych modeli LLM?
Tak. V100 32 GB zapewnia dużą pojemność HBM2 i wysoką przepustowość pamięci. Sprawdza się m.in. przy inferencji modeli LLM w FP16 lub kwantyzacji. Należy jednak uwzględnić, że architektura Volta nie obsługuje BF16 ani nowszych funkcji dostępnych w kolejnych generacjach GPU.
Jak testowane są używane karty Tesla V100?
Każda karta przechodzi kwalifikację na stanowisku testowym przed instalacją w serwerze: odczyt trwałych identyfikatorów egzemplarza, test pamięci, burn-in pod obciążeniem z nadzorem termicznym i sprawdzenie poprawności obliczeń. Do każdej sztuki wystawiamy certyfikat przypisany do egzemplarza. Szczegóły: jak sprawdzamy każdy używany akcelerator GPU.
Jak certyfikowany jest cały serwer?
Złożony serwer przechodzi osobny przebieg certyfikacyjny w końcowej konfiguracji wysyłkowej. Najpierw system automatycznie sprawdza zgodność wykrytego sprzętu z profilem oczekiwanym dla konkretnego egzemplarza, stan iDRAC, BIOS, firmware, zasilanie, sieć, RAID, pamięć oraz parametry PCIe każdej karty GPU.
Następnie wykonywane są testy CPU, RAM, nośników, GPU i obciążenie całego systemu. Po zakończeniu wyniki porównywane są ze stanem wejściowym, w tym liczniki ECC i logi błędów.
Certyfikat jest wystawiany tylko wtedy, gdy zarówno sprzęt, jak i kompletność materiału dowodowego spełniają wymagania procedury certyfikacyjnej. Do serwera dołączany jest certyfikat z kodem weryfikacyjnym oraz inwentarz sprzętu z numerami seryjnymi. Pełny opis: certyfikacja serwerów AI.
Kwalifikacja pojedynczej karty GPU jest osobnym procesem i nie zastępuje certyfikacji całego serwera: inne narzędzia, inne warunki chłodzenia, inny przedmiot oceny. Wyników pomiarowych z obu procesów nie należy porównywać bezpośrednio.
Czy certyfikacja zapisuje cokolwiek na dyskach serwera?
Nie zapisuje danych ani wzorców testowych. Przebieg uruchamiamy z nośnika live, z systemem działającym w pamięci RAM. Certyfikacja nie instaluje systemu, nie partycjonuje, nie formatuje i nie wykonuje testów zapisujących dane użytkownika ani wzorce testowe na przestrzeni danych nośników docelowych. Stan dysków jest oceniany przez SMART oraz self-test dostępny dla danego typu nośnika, firmware i kontrolera RAID. Self-test wykonuje sam nośnik, a jego firmware może przy tym zaktualizować własny dziennik diagnostyczny SMART. Jeżeli pełny długi self-test nie jest obsługiwany lub jego wynik nie może być wiarygodnie uzyskany przez warstwę kontrolera, procedura odpowiednio uwzględnia ten fakt w końcowej kwalifikacji przebiegu.
Czy serwer jest dostarczany z systemem operacyjnym?
Tak. Serwer jest dostarczany z preinstalowanym Ubuntu, właściwym sterownikiem NVIDIA oraz naszymi skryptami testowymi umożliwiającymi weryfikację działania sprzętu po odbiorze. Te skrypty to self-test odbiorczy, narzędzie osobne od certyfikacji: potwierdza obecność i działanie podzespołów po dostawie, nie ocenia wydajności i nie wystawia certyfikatu.
Jaka jest gwarancja na serwer AI?
Standardowe konfiguracje Dell PowerEdge R740 AI są objęte gwarancją 12 miesięcy.
Potrzebujesz pomocy w doborze liczby kart GPU?
Prześlij informacje o planowanym modelu lub obciążeniu. Przygotujemy konfigurację i wycenę, zwykle w ciągu jednego dnia roboczego.