
NVIDIA TESLA V100 32 GB
Moc AI. Bez kompromisów.
Akcelerator GPU do treningu deep learning i inferencji.
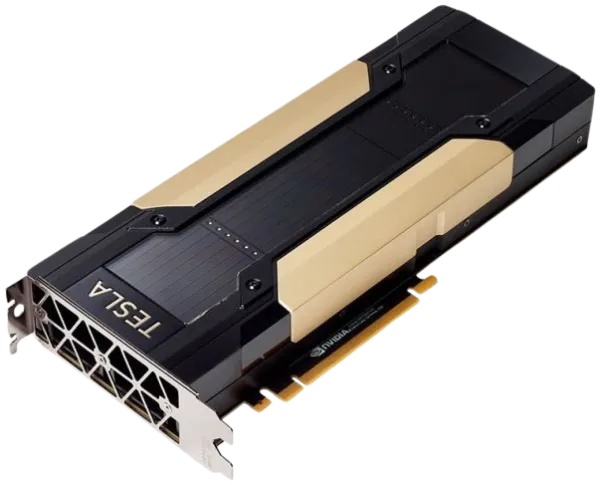
5 120 rdzeni CUDA640 rdzeni Tensor32 GB HBM2900 GB/s112 TFLOPS
Deep Learning
Trening modeli AI
FP16 na rdzeniach Tensor
HBM2 32 GB
Ultraszybka pamięć
900 GB/s przepustowości
Rdzenie Tensor
112 TFLOPS mocy
obliczeniowej
Pełna specyfikacja
- Architektura
- NVIDIA Volta (GV100)
- Pamięć
- 32 GB HBM2
- Przepustowość pamięci
- 900 GB/s
- Rdzenie CUDA
- 5120
- Rdzenie Tensor
- 640
- Wydajność FP64
- 7 TFLOPS
- Wydajność FP32
- 14 TFLOPS
- Wydajność Tensor
- 112 TFLOPS
- Interfejs
- PCIe 3.0 ×16
- TDP
- 250 W
- Chłodzenie
- Pasywne (serwerowe)
- Format
- Dwuslotowy, pełna wysokość
- Zasilanie
- 8-pin EPS
- W komplecie
- Kabel zasilający 2× PCIe 8-pin → EPS 8-pin
- Stan
- Używany
- Gwarancja
- 3 miesiące
- Kwalifikacja
- 6-etapowa kwalifikacja techniczna (m.in. gpu-burn 600 s) — wynik PASS, certyfikat kwalifikacji
Baza wiedzyPoradniki i testy dotyczące tego modelu6 artykułów
2× GPU do LLM: jak llama.cpp dzieli model między P40 i V100
PLLuM lokalnie na używanej Tesli - jak odpalić i ile VRAM
Benchmarki: Bielik i PLLuM na P40/P100/V100 - realne tokeny/s z czasem prefill
V100 czy A2 do fine-tuningu modeli? Uczciwe porównanie dwóch używek
GPU do laboratorium i na uczelnię bez budżetu na H100 - jak zbudować stanowisko AI/HPC taniej
Ile VRAM potrzeba do uruchomienia Llama 7B, 13B i 70B?
Potrzebujesz kompletnego serwera?
Tesla V100 32 GB jest dostępna również jako część gotowej platformy Dell PowerEdge R740 z 1-3× V100 32 GB, przygotowanej z odpowiednimi riserami, chłodzeniem, zasilaniem i okablowaniem GPU.