
NVIDIA TESLA P4 8 GB
Inferencja AI. Niski pobór mocy.
Kompaktowy akcelerator GPU do inferencji w centrach danych o niskim TDP.
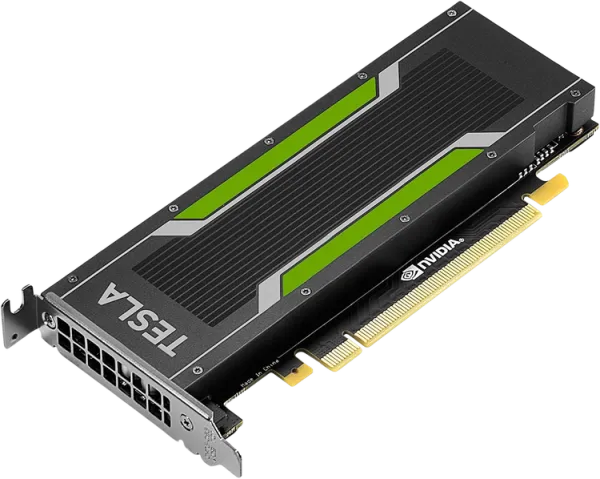
2 560 rdzeni CUDA8 GB GDDR5192 GB/s22 TOPS INT8
Inferencja
Zoptymalizowana do
wnioskowania INT8
GDDR5 8 GB
8 GB pamięci
GDDR5
75 W TDP
Pasywne chłodzenie,
bez dodatkowego zasilania
Pełna specyfikacja
- Architektura
- NVIDIA Pascal (GP104)
- Pamięć
- 8 GB GDDR5
- Przepustowość pamięci
- 192 GB/s
- Rdzenie CUDA
- 2560
- Wydajność FP32
- 5,5 TFLOPS
- Wydajność INT8
- 22 TOPS
- Interfejs
- PCIe 3.0 ×16
- TDP
- 75 W
- Chłodzenie
- Pasywne (serwerowe)
- Format
- Jednoslotowy, niski profil
- Zasilanie
- Przez gniazdo PCIe (bez dodatkowego złącza)
- W komplecie
- Śledź PCIe wysoki i niski
- Stan
- Używany
- Gwarancja
- 3 miesiące
- Kwalifikacja
- 6-etapowa kwalifikacja techniczna (m.in. gpu-burn 600 s) — wynik PASS, certyfikat kwalifikacji
Baza wiedzyPoradniki i testy dotyczące tego modelu6 artykułów
2× GPU do LLM: jak llama.cpp dzieli model między P40 i V100
Whisper po polsku na GPU - transkrypcja i napisy lokalnie (RODO)
RAG na firmowych dokumentach offline - jaki sprzęt i jak zacząć (RODO)
Ile prądu pobiera używana Tesla - i która daje najwięcej tokenów na wat
Jak sprawdzamy każdy używany akcelerator GPU, zanim trafi do Ciebie - 6 etapów kwalifikacji i co jest na certyfikacie
NVENC i NVDEC w Teslach - która karta koduje wideo, ile sesji i jakie kodeki (matryca)